16 de octubre de 2026 · 5 min de lectura
Cómo corro Qwen3.8-Flash-Next en mi Ryzen AI Max+ 395 con Windows
La receta que uso para correr Qwen3.8-Flash-Next en local en un Strix Halo de 128 GB con Windows: por qué descarté Strata, cómo lo dejé en llama.cpp con Vulkan y MTP a 27 tokens por segundo, y cómo se compara con Qwen3.6-35B-A3B y Qwen3.8-27B.
Esta es la receta que uso hoy para correr Qwen3.8-Flash-Next en local, en Windows, sin Linux de por medio. Te cuento qué máquina tengo, qué probé primero, qué terminé haciendo y cómo se compara con los otros modelos que uso. Si tienes un equipo parecido, deberías poder replicarlo paso a paso.
Qué máquina tengo
Un Ryzen AI Max+ 395, lo que AMD llama Strix Halo, con la Radeon 8060S integrada (40 CUs RDNA 3.5, gfx1151) y 128 GB de memoria unificada LPDDR5X-8000. Corre Windows 11 Pro. La BIOS reserva 64 GB para la GPU y Windows ve los otros 64. Revisa cuánto le reservas a la GPU antes de hacer cuentas de memoria.
Qué modelo quería instalar y por qué
Hasta ahora usaba dos modelos: Qwen3.6-35B-A3B para el día a día, porque es muy rápido, y Qwen3.8-27B para lo difícil, porque es más listo pero lento (19.5 tokens por segundo).
Qwen3.8-Flash-Next es un MoE grande y disperso: 48 capas de 512 expertos, de los que usa 10 por token, unos 6B de parámetros activos. Según Qwen, empata con el 27B en SWE-bench Pro (62.5 contra 61.7). Mi pregunta era simple: ¿me da respuestas de nivel 27B a una velocidad con la que pueda vivir?
Por dónde intenté primero: Strata
Strata es un motor de inferencia con licencia MIT, hecho sobre ggml y pensado justo para esta familia de modelos. Tiene instalador de un clic, y el soporte para Strix Halo es experimental. Su documentación dice que Windows en Strix Halo no está probado, pero quise intentarlo.
La instalación fue fácil:
START-HERE.bat --check
START-HERE.bat --yes --family unsloth --model UD-IQ4_XS --context 262144 --no-start
El primero detecta la GPU y te recomienda cuantización (en mi caso, UD-IQ4_XS de Unsloth). El segundo descarga unos 94 GB y deja todo listo.
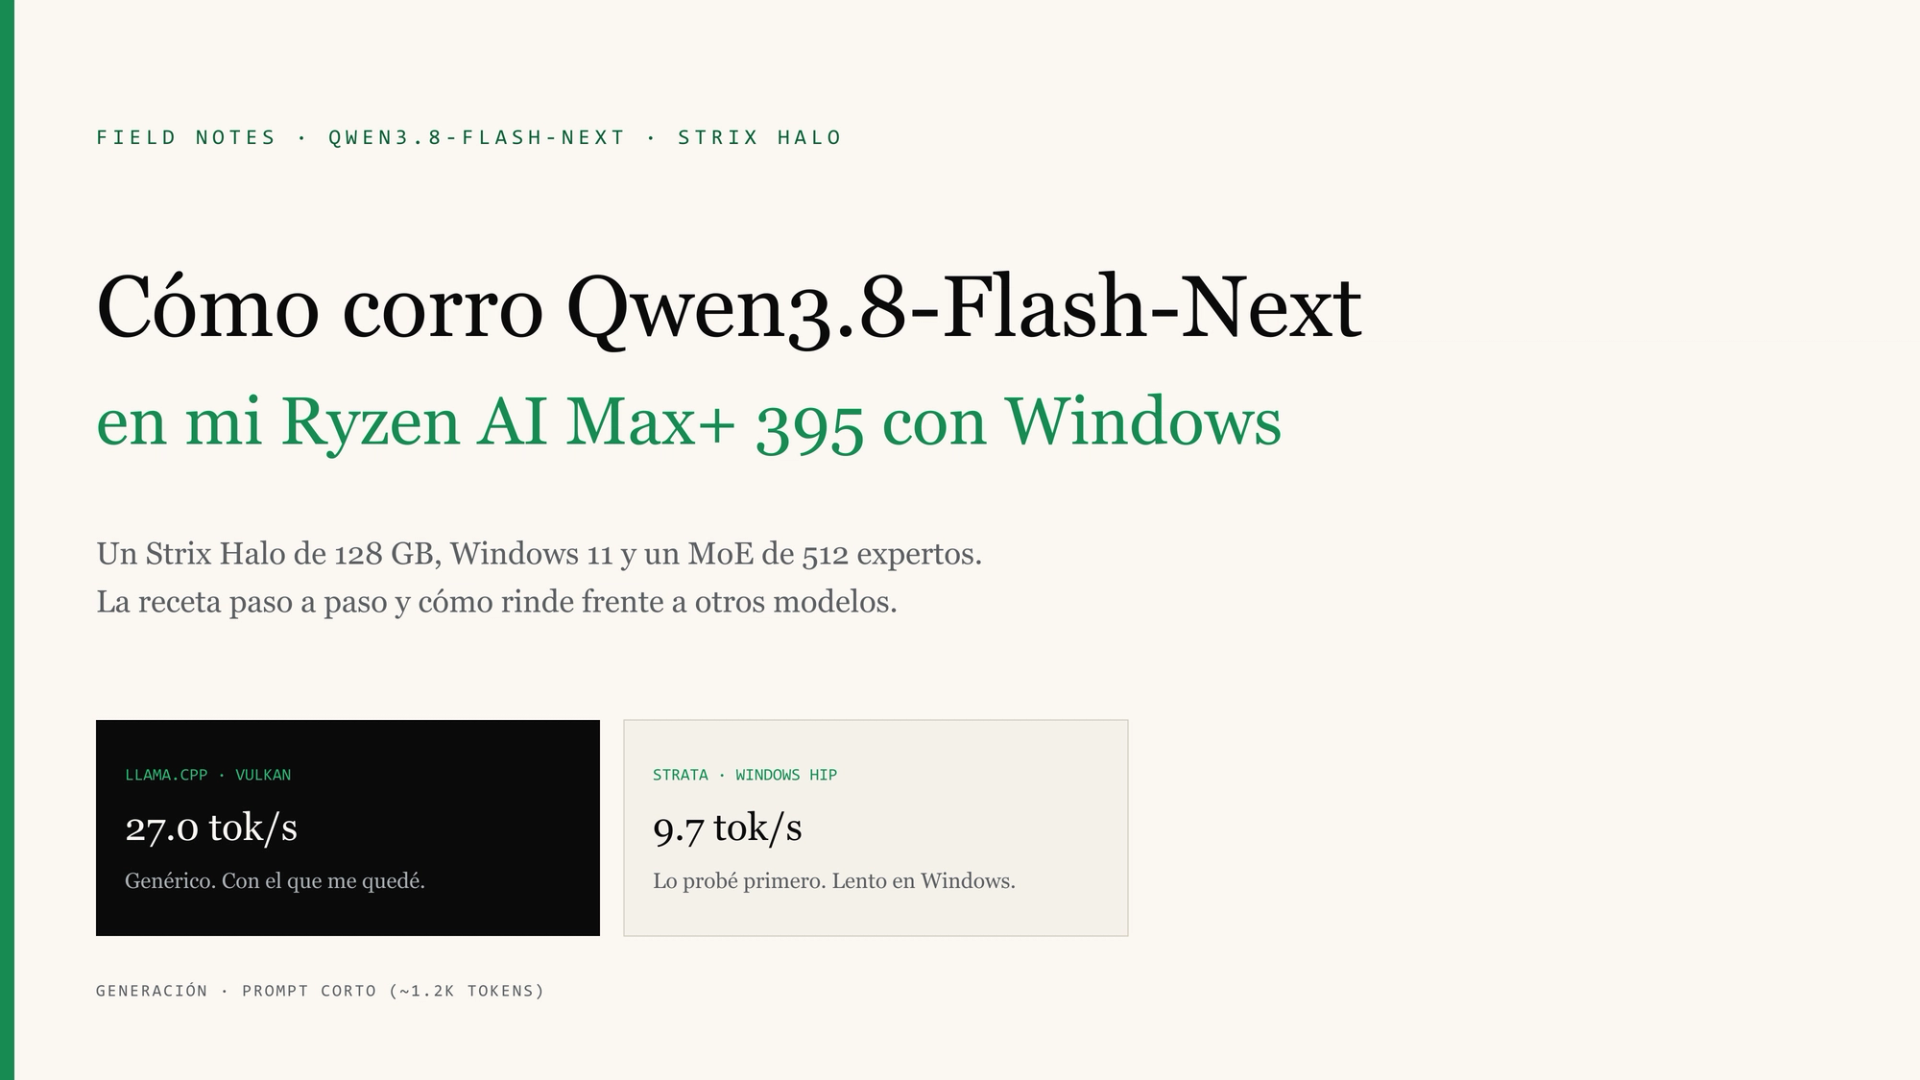
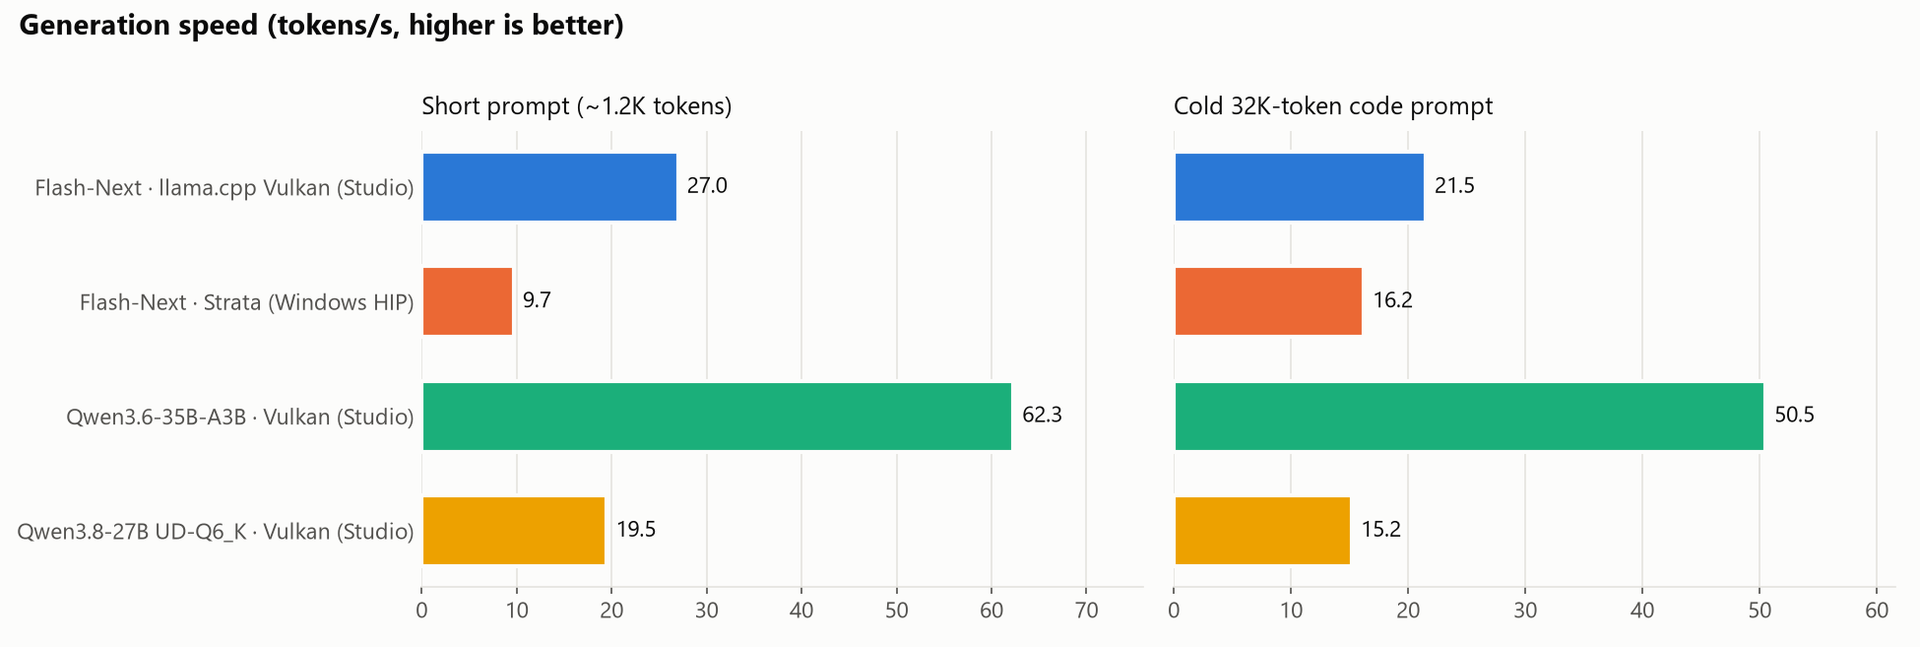
El resultado: funciona, pero lento. Entre 9.7 y 11.7 tokens por segundo en prompts cortos. Eso sí, procesa prompts largos muy bien (496 tokens por segundo con un prompt de 32K).
¿Por qué? No era la memoria: el 99% del trabajo corría en la GPU. El cuello de botella es la ruta HIP de Strata en Windows para este chip. En Linux, sus mantenedores reportan unos 53 tokens por segundo con el mismo modelo, así que el problema es Windows, no el hardware.
Qué hice: llama.cpp con Vulkan, vía Unsloth Studio, con MTP
Yo ya uso Unsloth Studio, la app de escritorio que levanta un servidor compatible con OpenAI y Anthropic en 127.0.0.1:8888 sobre llama.cpp con Vulkan. La versión de llama.cpp de Unsloth ya soporta esta arquitectura y la decodificación especulativa con MTP (una pequeña cabeza que adivina los siguientes tokens). Así que usé los mismos archivos GGUF que había descargado Strata.
Estos son los pasos:
1. Aprovecha la descarga. Studio lee la caché de Hugging Face. En lugar de bajar otros 94 GB, moví los tres archivos del modelo a models--unsloth--Qwen3.8-Flash-Next-GGUF/snapshots/<commit>/UD-IQ4_XS/ y escribí el hash del commit en refs/main. Antes comprobé que el SHA-256 de cada archivo coincidiera con el de Hugging Face. Studio listó el modelo al momento y bajó solo la cabeza MTP.
2. Guarda un perfil para el modelo. En Studio, con "Remember for this model": contexto de 262K, caché KV en q8_0, MTP con 2 borradores, un solo slot y esfuerzo de razonamiento bajo.
3. Arregla la memoria. Aquí me tropecé. Con -ub 2048 todo iba bien en las pruebas de velocidad, pero a mitad de las de calidad el servidor se cayó con decode() failed: bad allocation. No era la VRAM. Era el límite de memoria comprometida de Windows: 160 de 168 GB, y llama-server solo ocupaba 113. En Windows, la memoria de la GPU cuenta contra ese límite, y Studio cargaba completa en RAM una tabla de embeddings de 27 GB que el modelo apenas consulta.
La solución son dos cambios:
--load-mode mmap --lazy-mode on: la tabla de 27 GB se queda en el SSD y se lee bajo demanda. Libera unos 31 GB y la velocidad no cambia.-ub 1024en lugar de 2048: reduce a la mitad los buffers de cálculo.
Con eso quedé en 124 de 164 GB comprometidos y unos 31 GB de RAM libre.
4. Pon el razonamiento en bajo. Esto es obligatorio. Con la configuración por defecto, Flash-Next se gastó 12,000 tokens (10 minutos) pensando en un parser y nunca escribió el código. Con --reasoning-effort low, la misma tarea le tomó unos 3,400 tokens.
5. La configuración final. Este es mi perfil en Studio, equivalente a estos flags de llama-server:
-c 262144 -np 1 -fa on -ub 1024 --cache-type-k q8_0 --cache-type-v q8_0
--model-draft mtp-Qwen3.8-Flash-Next-Q8_0.gguf
--spec-type draft-mtp --spec-draft-n-max 2
--ctx-checkpoints 4 --cache-ram 0
--reasoning on --reasoning-budget 16384 --reasoning-effort low
--load-mode mmap --lazy-mode on
Resultado: 27.0 tokens por segundo en prompts cortos y 21.5 con un prompt de 32K. Casi el triple que con Strata en prompts cortos.
Cómo se ve contra mis otros modelos
Los medí con los mismos prompts. Para calidad usé ocho pruebas: seis tareas de programación calificadas con tests, una llamada de herramientas en paralelo y una extracción con esquema JSON.
- Modelo (Windows 11, Vulkan): Qwen3.6-35B-A3B · Tokens/s, prompt corto: 62.3 · Tokens/s, prompt de 32K: 50.5 · Calidad: 7/8
- Modelo (Windows 11, Vulkan): Qwen3.8-27B (UD-Q6_K) · Tokens/s, prompt corto: 19.5 · Tokens/s, prompt de 32K: 15.2 · Calidad: 8/8
- Modelo (Windows 11, Vulkan): Qwen3.8-Flash-Next (UD-IQ4_XS) · Tokens/s, prompt corto: 27.0 · Tokens/s, prompt de 32K: 21.5 · Calidad: 7/8
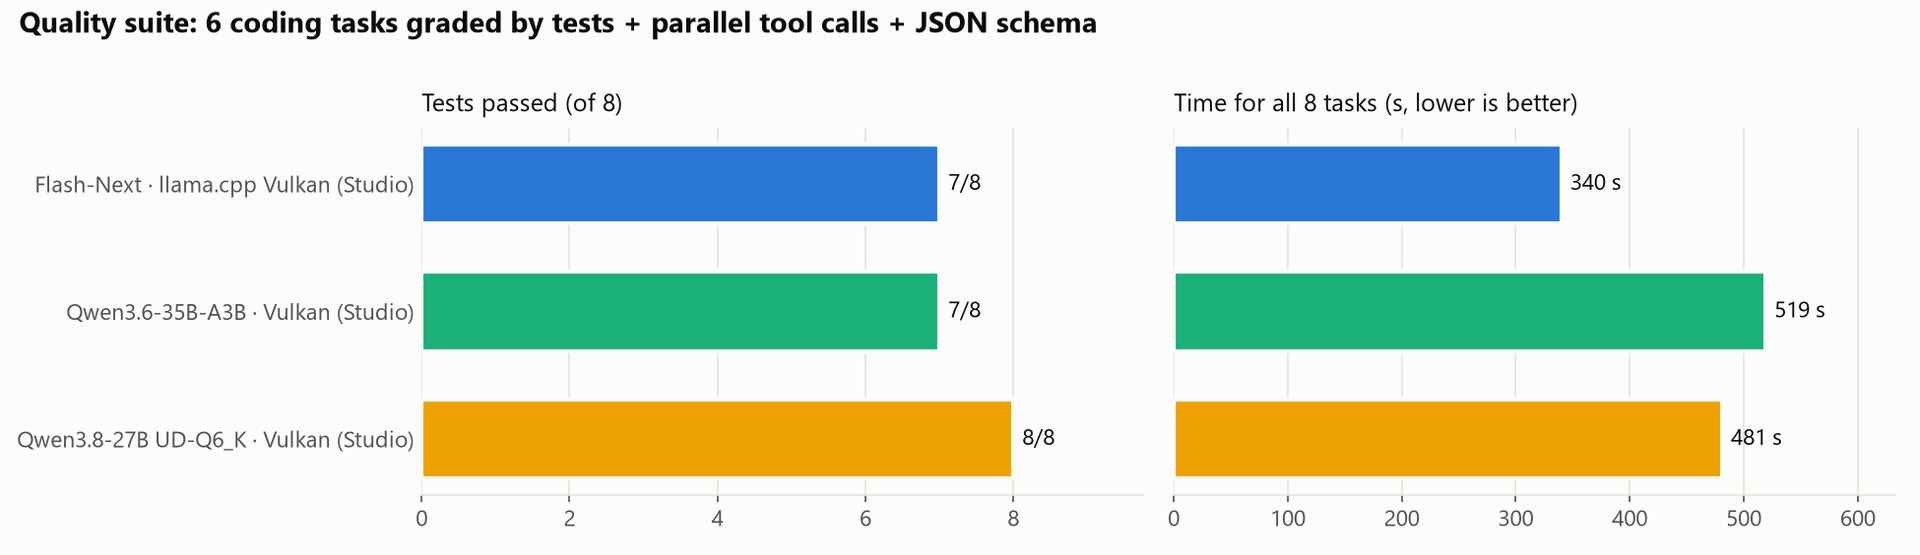
Ocho pruebas son muy pocas para ordenar a los tres; cada uno falló una tarea distinta. Lo que sí muestran es que juegan en la misma liga, y que Flash-Next terminó la batería más rápido: en un 30% menos de tiempo que el 27B.
Así los uso ahora:
- Qwen3.6-35B-A3B para el día a día. Sigue siendo, por mucho, el más rápido.
- Qwen3.8-Flash-Next para los problemas difíciles. Reemplaza al 27B: resultados parecidos en mis pruebas, con generación 1.4 veces más rápida y procesamiento de prompts 1.5 veces más rápido.
- Un solo modelo cargado a la vez. Flash-Next ocupa unos 62 GB de la memoria de la GPU más unos 14 GB de memoria compartida.
Si tienes esta máquina con Windows, la receta es corta: llama.cpp con Vulkan, MTP con 2 borradores, razonamiento en bajo y la tabla de embeddings cargada en modo lazy. En Linux dicen que se puede ir bastante más rápido, pero eso es para otro post.
Comentarios(0)
Sé el primero en comentar.
Sigue leyendo